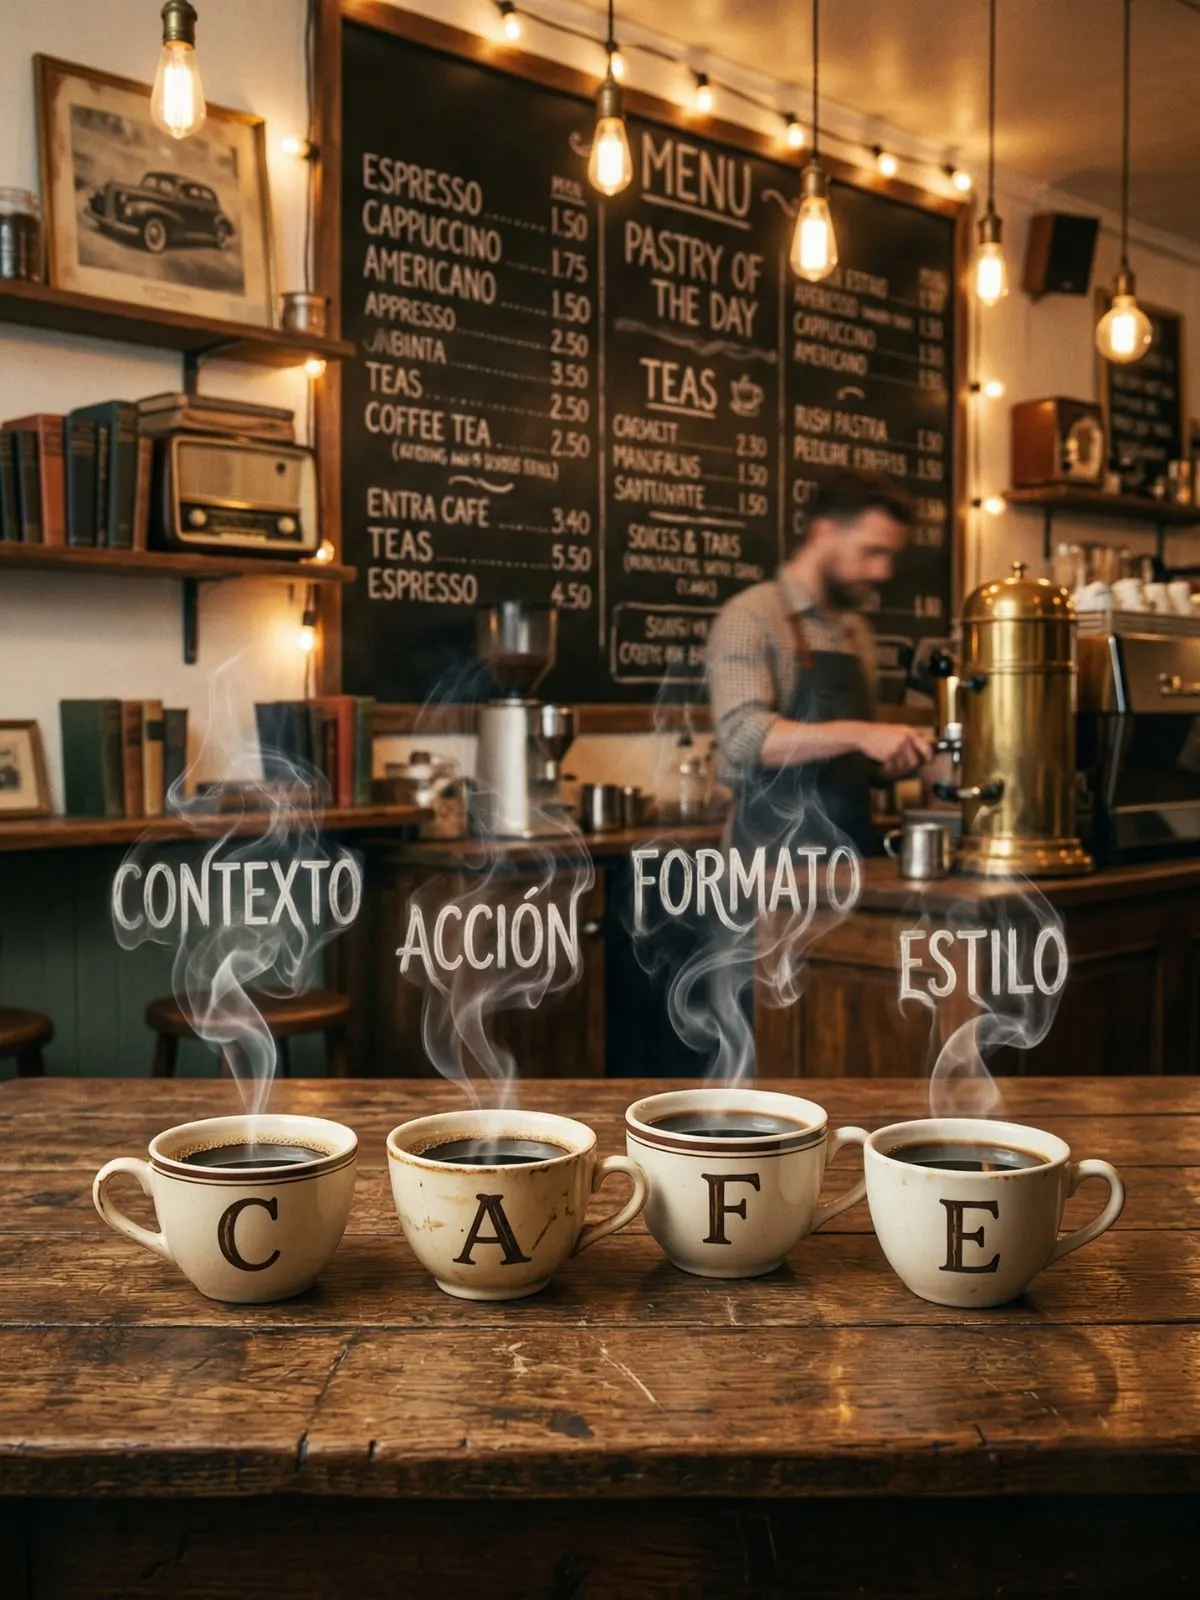
Método CAFÉ — el framework completo que transforma cada prompt
Cuatro letras, un lenguaje común. El framework que uso todos los días en mi consultora para que la IA deje de responderle al usuario promedio y empiece a responderte a vos.
Germán Falcioni✦ Lectura: 11 min
Abrí un hilo de Claude Desktop, otro de ChatGPT, uno de Cursor, uno de Perplexity Pro. Pedí que cada uno generara una pieza de análisis similar. Después exporté los system prompts reportados por la comunidad para cada una de esas aplicaciones. Y empecé a mirar qué los hacía funcionar.
Los system prompts de aplicaciones serias de IA — los que los equipos de producto ajustan durante meses antes de un lanzamiento — tienen una estructura que se repite con una consistencia que no es casual. Definen quién es el asistente y el contexto en el que opera. Definen qué acciones específicas tiene permitidas y cuáles no. Definen el formato exacto de cada tipo de respuesta. Y definen el registro, la voz, el estilo.
Son, sin que nadie lo haya nombrado así, prompts CAFÉ. Los ingenieros de prompt en laboratorios estructuran así sin darle nombre al patrón. Yo puse el nombre para uso cotidiano. Esa es toda la novedad del método, y es suficiente — porque lo que no tiene nombre no se enseña, y lo que no se enseña no escala fuera del laboratorio.
Nota metodológica
Los ejemplos que siguen están hechos con Claude Opus 4.7. Es la herramienta que uso en mi consultora todos los días y con la que puedo reportar comportamiento observado con precisión. El método funciona con cualquier IA generativa: la lógica de los cuatro componentes es independiente del modelo subyacente. Si reemplazás Claude por ChatGPT, por Gemini, por Grok o por un modelo open source decente, los mismos cuatro componentes producen outputs comparables en calidad relativa — aunque la salida textual específica varíe.
El patrón que CAFÉ nombra
Cualquiera que haya hecho prompt engineering en serio durante más de seis meses sabe esto: los cuatro componentes que CAFÉ señala son los mismos que Anthropic recomienda en su guía oficial de prompt engineering, los mismos que OpenAI lista en su guide de best practices, los mismos que Google documenta para Gemini. No es casualidad. Es que el problema técnico de fondo — cómo condicionar la generación de un LLM hacia un output útil — tiene una estructura que admite solución en cuatro dimensiones relativamente ortogonales.
Contexto condiciona el prior. Un modelo de lenguaje genera respuestas condicionadas por el input. Un contexto rico activa subespacios de respuesta más específicos y relevantes. Sin contexto, el modelo defaultea a la distribución modal — la respuesta más probable para el usuario promedio. Con contexto, genera desde una posición específica en el espacio semántico. La literatura académica lo llama "in-context learning" y lo considera una de las capacidades emergentes más importantes de los modelos a escala.
Acción reduce el espacio de búsqueda. Un prompt con verbo vago ("ayudame con") deja abierto un árbol de decisión enorme — el modelo tiene que inferir qué querés. Un prompt con verbo concreto ("escribí un email de seguimiento de seis líneas") acota el espacio de respuesta drásticamente. La diferencia en calidad no es gradual — es qualitative, porque el costo de razonar sobre ambigüedad suele superar el presupuesto implícito de cómputo que el modelo dedica a la tarea.
Formato impone estructura explícita. Los modelos son muy buenos siguiendo estructura cuando se la das, y bastante arbitrarios cuando no. Pedir "una tabla con columnas nombre, ventaja, costo" produce exactamente eso. No pedirlo produce párrafos sueltos, a veces listas, a veces encabezados, dependiendo del estado latente del modelo en esa generación.
Estilo ajusta la superficie sin tocar el contenido. Es el componente más subestimado y el que más diferencia hace en output final entregable. Un mismo contenido con el estilo equivocado es inutilizable. Mismo contenido con el estilo correcto es publishable. La diferencia no es cosmética — es operativa.
CAFÉ como generalización
La tesis interesante no es que CAFÉ funcione. Es que CAFÉ es una generalización explícita del patrón que ya está implícito en cualquier prompt serio.
Otros frameworks existen: RACE (Role, Action, Context, Expectation), CO-STAR (Context, Objective, Style, Tone, Audience, Response), RISEN (Role, Instructions, Steps, End goal, Narrowing), CRISPE, y varios más. Todos capturan, con distintos cortes, el mismo espacio de cuatro a seis dimensiones. La ventaja de CAFÉ no es que sea más completo — es que tiene la cantidad correcta de letras para recordarlo sin consultar una hoja, y que esas letras se pronuncian en una palabra que cualquiera en el mundo hispano puede retener.
Dicho sin eufemismos: en prompt engineering no hay un framework técnicamente superior al resto. Hay uno que vas a usar porque te acordás de él en el momento en que estás por escribir el prompt, y hay otros que quedan guardados en un Notion que nunca abrís.
Caso completo: pipeline de análisis de contratos
Donde CAFÉ muestra su valor más claro es en pipelines reales — trabajos donde el output tiene que ser consistente a lo largo de decenas o cientos de ejecuciones.
Caso real de mi consultora: análisis preliminar de contratos comerciales para una firma legal. Volumen: cuarenta a sesenta contratos por mes.
Prompt sin CAFÉ: "Analizá este contrato y decime qué problemas tiene."
Output: variable. A veces una lista de riesgos. A veces un resumen narrativo. A veces una tabla. La firma legal no puede auditar el trabajo porque cada salida tiene una estructura distinta.
Prompt con CAFÉ completo:
Contexto. Sos un abogado senior especializado en contratos comerciales con quince años de experiencia en el mercado argentino. Estás haciendo una revisión preliminar para una firma legal que necesita identificar riesgos para después profundizar en los más críticos. El contrato adjunto es un contrato de distribución entre una empresa argentina (principal) y una distribuidora chilena. Acción. Identificá las cláusulas que pueden generar riesgo legal o comercial. Para cada cláusula riesgosa, extraé el texto literal, indicá la categoría del riesgo (legal, operativo, financiero, jurisdiccional), evaluá severidad en escala 1-5, y proponé una pregunta para el abogado senior que decida si profundizar. Formato. Tabla Markdown con columnas: Cláusula (número y título), Texto literal (máximo 200 caracteres), Categoría, Severidad, Pregunta para profundizar. Después de la tabla, un resumen ejecutivo de tres líneas con el número total de riesgos altos (severidad 4-5), el tema dominante, y la recomendación general. Estilo. Profesional legal sin ornamento. Voz activa. Precisión técnica. No uses "se podría interpretar" cuando querés decir "se interpreta"; si hay ambigüedad genuina, nombrala explícitamente.
Output: una tabla idéntica en estructura en cada ejecución, con contenido específico al contrato. La firma legal puede auditar, comparar contratos entre sí, construir métricas agregadas sobre tipos de riesgo, entrenar a junior con los outputs. El pipeline funciona porque el prompt funciona. El prompt funciona porque tiene los cuatro componentes.
Sin el F de Formato, cada ejecución tiene estructura distinta y el trabajo downstream se duplica. Sin el É de Estilo, la voz varía entre ejecuciones y el output pierde autoridad. Sin la A de Acción, el modelo interpreta "problemas" de manera distinta cada vez. Sin el C de Contexto, la análisis se hace desde la posición de un abogado genérico en lugar de un senior especializado — y eso cambia qué riesgos se ven y cuáles se pasan por alto.
Lo que CAFÉ no es
Vale ser honesto sobre los límites del método.
CAFÉ no es prompt engineering avanzado. No cubre chain-of-thought, few-shot examples, self-consistency, tool-use, ni técnicas de agente multi-step. Es el nivel fundacional — la base sobre la cual esas técnicas se construyen. Si tu caso de uso requiere razonamiento multi-paso complejo o herramientas externas, CAFÉ es el punto de partida, no el punto de llegada.
CAFÉ tampoco sustituye juicio editorial. El output de un prompt CAFÉ bien armado es un primer borrador de alta calidad. Todavía lo tenés que leer, criticar, y ajustar. La proposición del método no es "automatizás el pensamiento"; es "reducís la fricción entre lo que querés y lo que la herramienta devuelve".
Y CAFÉ no es un diferenciador competitivo a largo plazo. A medida que los modelos mejoran, van a ser más tolerantes a prompts mal estructurados — ya lo están siendo. Lo que no cambia es que tener una forma consistente de pedir produce outputs consistentes. Ese es el verdadero valor, y ese valor escala en vez de erosionarse.
Tesis editorial
Cierro con la tesis que orienta todo el resto de esta serie.
El prompt engineering no va a desaparecer con los próximos modelos — va a transformarse. Los modelos van a perdonar más la ambigüedad, pero el que escriba prompts explícitos va a seguir obteniendo outputs más predecibles, más auditables, más integrables en pipelines reales. La diferencia entre "la IA a veces me sirve" y "la IA es parte de mi pipeline" no es el modelo: es la disciplina con la que formulás el pedido.
CAFÉ es esa disciplina en formato mínimo. No es la única forma de estructurar un prompt. Es la forma que podés recordar mientras tomás un café, y esa portabilidad cognitiva es lo que hace que se use — no que se sepa. Hay una diferencia grande entre esas dos cosas.
Cuando un método escala, no es porque sea el más sofisticado. Es porque es el que llega primero a la cabeza en el momento en que vas a actuar. CAFÉ está diseñado para eso. Y a medida que los modelos mejoran, CAFÉ no se vuelve obsoleto — se vuelve más valioso, porque la consistencia en el pedido se compone con la consistencia en el modelo y produce outputs profesionalmente confiables. Esa composición es, hoy por hoy, la diferencia más grande entre un equipo que usa IA con entusiasmo y un equipo que usa IA con rigor.
¿Cuál es tu proceso actual cuando un prompt no te devuelve lo que esperabas — reescribís todo el prompt, o intentás identificar cuál de los componentes falló?