Cómo “piensa” una IA — sin jerga, para humanos
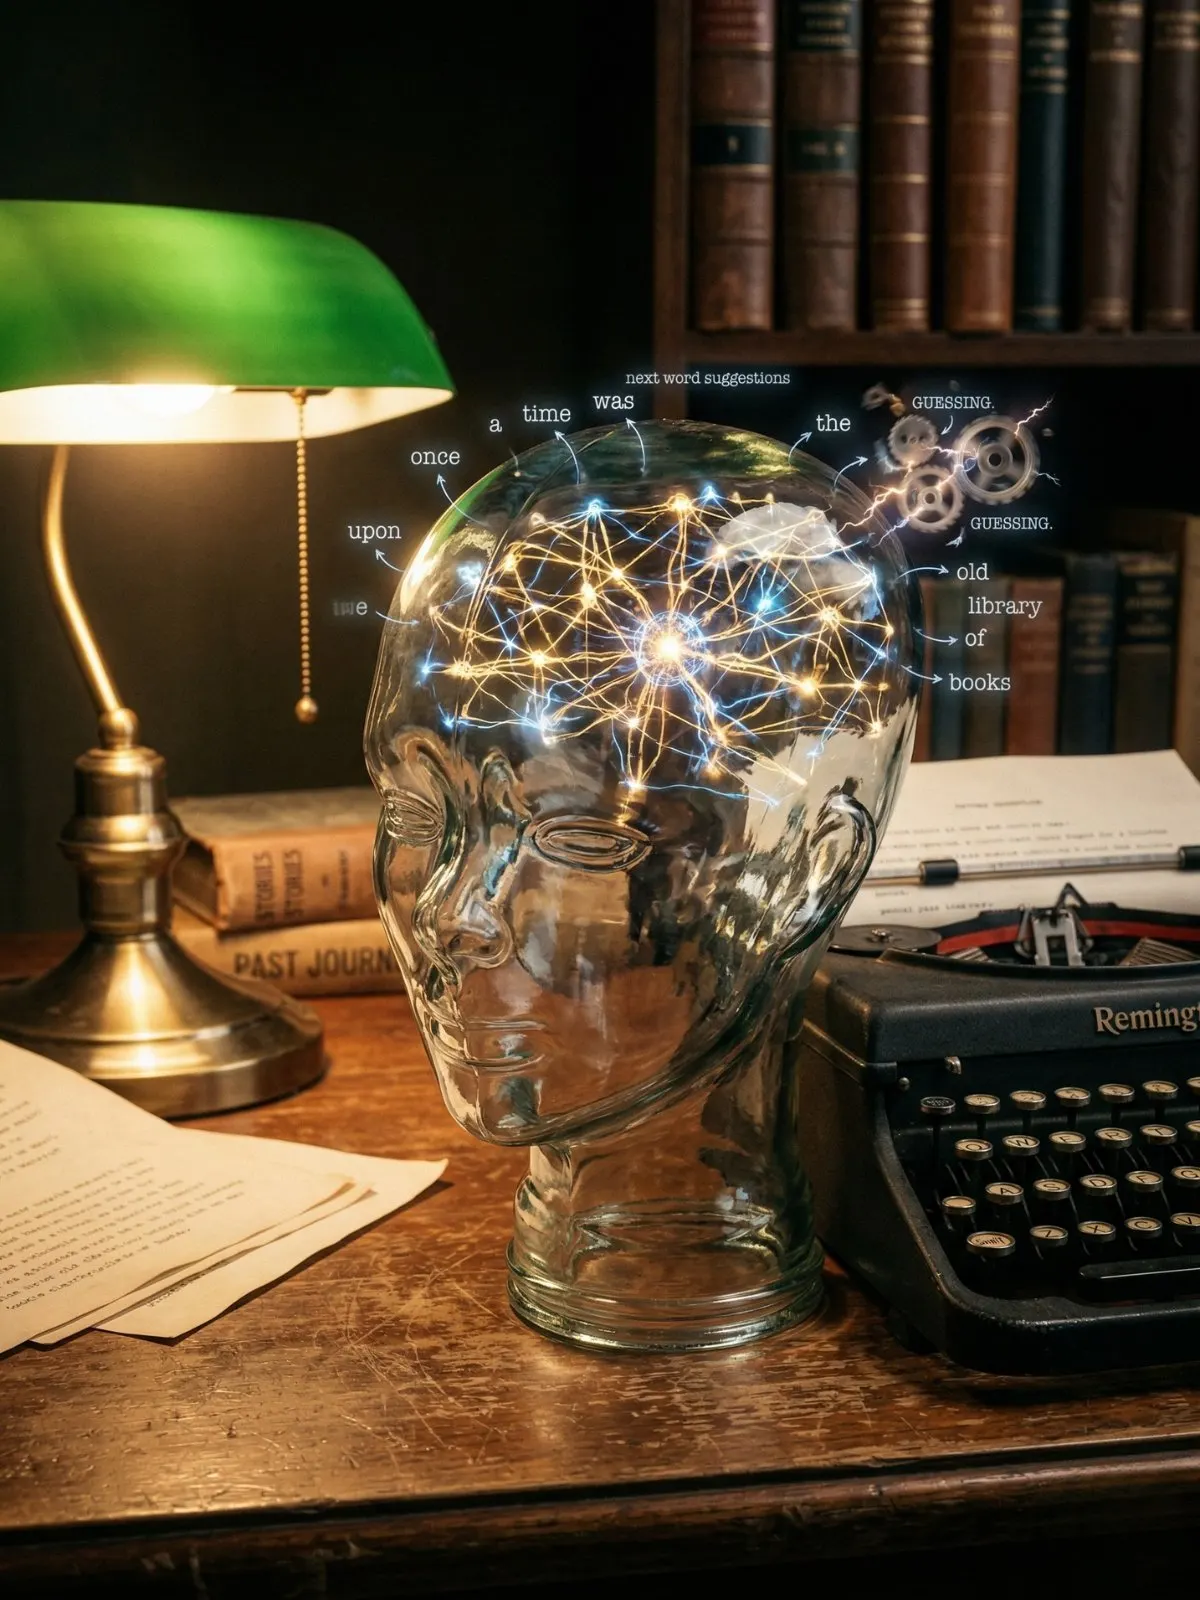
La IA no piensa. Adivina la próxima palabra. Te mostramos cómo, y por qué eso alcanza para cambiar tu trabajo.
Germán Falcioni✦ Lectura: 8 min
Cómo "piensa" una IA — sin jerga, para humanos
Por qué entender la mecánica te hace mejor usuario
Si usás una IA sin saber cómo funciona por dentro, tenés suerte cuando funciona y frustración cuando no. Entender la mecánica te permite construir mejores prompts, diagnosticar fallos, saber cuándo confiar y cuándo dudar.
Esto no es una disertación académica. Es ingeniería inversa pragmática para cualquiera que vaya a apoyar decisiones reales en modelos de lenguaje.
La IA no piensa. Ejecuta transformaciones matemáticas sobre vectores de alta dimensión para estimar distribuciones de probabilidad sobre el vocabulario. Traducido: predice qué palabra viene después a partir de patrones aprendidos durante el entrenamiento.
La arquitectura transformer
El paper clave es Vaswani et al., "Attention Is All You Need" (NeurIPS 2017). Ocho páginas que cambiaron todo. La innovación central: el mecanismo de atención.
Hasta ese momento, los modelos de lenguaje procesaban texto secuencialmente, con arquitecturas llamadas RNN o LSTM. Lento. Difícil de escalar. Transformers rompieron ese techo.
Vos escribís: "El gato entró en la casa y se durmió en la silla porque estaba...". El modelo no procesa palabra por palabra. Procesa el párrafo entero simultáneamente y la atención decide matemáticamente cuánto pesa cada palabra anterior para predecir la siguiente.
Eso vive en pesos de atención. Números entre 0 y 1. En este ejemplo: "gato" podría pesar 0,4, "durmió" 0,3, "silla" 0,2, el resto se reparte el 0,1. Luego el modelo combina esos pesos y genera una distribución de probabilidad para la siguiente palabra: "cómodo" 0,52, "cansado" 0,18, "tranquilo" 0,09, miles de otras opciones con probabilidades menores.
El modelo puede tomar la más probable (modo greedy), o muestrear de la distribución con cierta temperatura para dar variedad. Ese es el único lugar donde hay algo parecido a "creatividad": ruido controlado sobre una distribución.
Embeddings: la geometría del significado
Cada token vive como un embedding — un vector en un espacio matemático de miles de dimensiones. No es "la palabra gato". Es un punto en un espacio abstracto.
La propiedad útil: palabras semánticamente cercanas están cerca en ese espacio. "Gato", "felino", "minino" forman un clúster. "Perro" está en otra región cercana. "Zapato" vive lejos.
Cuando el modelo predice, calcula distancias y productos internos en ese espacio. Es geometría pura. No hay comprensión. Hay coordenadas.
El famoso ejemplo del paper word2vec de Mikolov et al. (2013): "rey - hombre + mujer ≈ reina". Se resuelve con aritmética vectorial. Ese fue el momento en que la industria empezó a entender que el significado, a nivel operativo, se podía codificar geométricamente.
Tokens, no palabras
Detalle que mucha gente ignora: la IA no procesa palabras enteras. Procesa tokens. Fragmentos de subpalabra.
"Desorganizar" suele terminar como tres tokens: "Des", "organ", "izar". GPT-2 usa un vocabulario BPE (Byte Pair Encoding) de 50.257 tokens. Cifra oficial del paper de Radford et al. 2019. Modelos posteriores ampliaron ese vocabulario, pero el orden de magnitud se mantiene.
Esto tiene tres implicancias operacionales. Primero: pagás por token en las APIs, no por palabra. Segundo: los límites de contexto se miden en tokens, no en palabras. Tercero: idiomas distintos del inglés se fragmentan en más tokens, lo que los hace efectivamente más caros y más lentos.
Por qué unos modelos son mejores que otros
No es porque "piensen más" o "entiendan mejor". Son tres factores concretos.
Primero, datos de entrenamiento. Más volumen y mejor curación produce modelos que generalizan mejor. Anthropic, por ejemplo, ha publicado explícitamente que filtra datos para reducir contenido tóxico y priorizar calidad editorial. OpenAI mantiene más secreto. Google entrena con datos distintos. Cada corpus deja una huella.
Segundo, arquitectura y escala. Más parámetros no siempre es mejor, pero hasta cierto punto escala la capacidad representacional. Kaplan et al. (2020) y Hoffmann et al. (2022) publicaron "leyes de escala" que mapean cómo mejoran los modelos con más cómputo, más datos y más parámetros. La relación no es lineal y hay retornos decrecientes.
Tercero, fine-tuning y RLHF. Después del pretraining, los modelos se afinan con feedback humano. Reinforcement Learning from Human Feedback. Anthropic sumó una capa más: Constitutional AI (Bai et al. 2022), donde el modelo crítica sus propias salidas contra un conjunto de principios. Eso no cambia cómo predice internamente, pero cambia qué predice en situaciones sensibles y cuándo se rehúsa.
Por eso Claude tiende a reconocer "no sé" y decirlo, mientras otros modelos predicen con confianza respuestas falsas. No es virtud moral del modelo. Es elección de datos de afinamiento. Penalizaron más duro las alucinaciones confiantes durante RLHF.
Generalización limitada
Este es el punto que la mayoría de los analistas optimistas pasan por alto. La IA no generaliza como un humano.
Un humano ve tres ejemplos y extrae un principio. Una IA necesita millones de ejemplos. Y lo que "extrae" son correlaciones estadísticas, no principios causales.
Si le enseñás "A es como B, B es como C", un humano infiere "A es como C" sin dudarlo. Un modelo de lenguaje puede no hacerlo si esa cadena transitiva no apareció lo suficiente en sus datos. Hay papers recientes mostrando exactamente este tipo de fallo en tareas de razonamiento simbólico.
Implicaciones prácticas tres. Sesgos entrenados. Si los datos tenían sesgos, el modelo los reproduce como distribuciones. No por malicia, por estadística pura. Alucinaciones persistentes. Si algo suena estadísticamente plausible, el modelo lo genera, verdad o no. Debilidad en casos raros. Lo infrecuente en los datos produce patrones frágiles; por eso los modelos fallan con problemas lógicos atípicos.
Qué significa esto operacionalmente
Cinco principios que cambian cómo usás modelos de lenguaje si internalizaste lo anterior.
Primero, dale contexto abundante. Más contexto es más señal. Ejemplos, restricciones, estilo deseado. El prompt no es una orden. Es un marco donde el modelo muestrea.
Segundo, sé específico en la tarea. "Escribí un email" es un marco vago que produce salida promedio. "Escribí un email de 150 palabras pidiendo prórroga de pago a un proveedor en tono formal pero cercano" es un marco estrecho que colapsa la distribución hacia salidas útiles.
Tercero, verificá en dominios críticos. Plata, clientes, decisiones irreversibles. La salida del modelo puede sonar correcta aunque la predicción sea falsa. No hay semáforo interno.
Cuarto, usá modelos distintos para tareas distintas. Claude tiende a mejor calibración sobre incertidumbre. GPT-4 tiene fortalezas en código (entrenamiento con GitHub es público). Gemini empuja capacidades multimodales. No hay "el mejor". Hay "el mejor para tu caso".
Quinto, separá confianza de corrección. El modelo es igual de confiante cuando miente que cuando dice verdad. La confianza es output de la distribución, no garantía epistémica.
La tesis del blog
Escribí mucho sobre esto y llegué a una convicción que sostengo. La gente que mejor aprovecha la IA no es la más técnica ni la más entusiasta. Es la que internalizó la mecánica: esto es predicción estadística, no comprensión.
Los técnicos a veces se pierden en la matemática y olvidan que el producto final es texto generado en vivo frente al usuario. Los entusiastas a veces antropomorfizan y se decepcionan cuando el modelo falla en algo que "obviamente" tendría que saber.
Los buenos usuarios operan con una tercera postura. Saben que el modelo predice. Construyen sus prompts para darle señal. Verifican donde la verdad importa. Y no se asombran cuando falla, porque saben exactamente dónde termina la estadística y dónde empieza su responsabilidad humana.
La IA no entiende. Pero predice tan bien que podés construir sistemas reales con ella. El truco no está en esperar que entienda. Está en saber cuándo confiar en la predicción y cuándo pedir una segunda opinión.
¿Querés profundizar en algo del artículo?
01 ¿Las IAs realmente piensan?
No. Predicen la próxima palabra (o token) basándose en patrones estadísticos. Parece que piensan porque absorbieron cientos de miles de millones de palabras de texto.
02 ¿Por qué a veces miente una IA?
Porque predice. Si su mejor predicción es una palabra falsa pero estadísticamente plausible, la dice con la misma confianza que una verdadera.
03 ¿Funciona distinto si le doy más contexto?
Sí. Con contexto, el modelo ajusta sus predicciones basándose en lo que ya leyó en tu conversación. Es como darle pistas.